Как ICML 2026 меняет ландшафт искусственного интеллекта
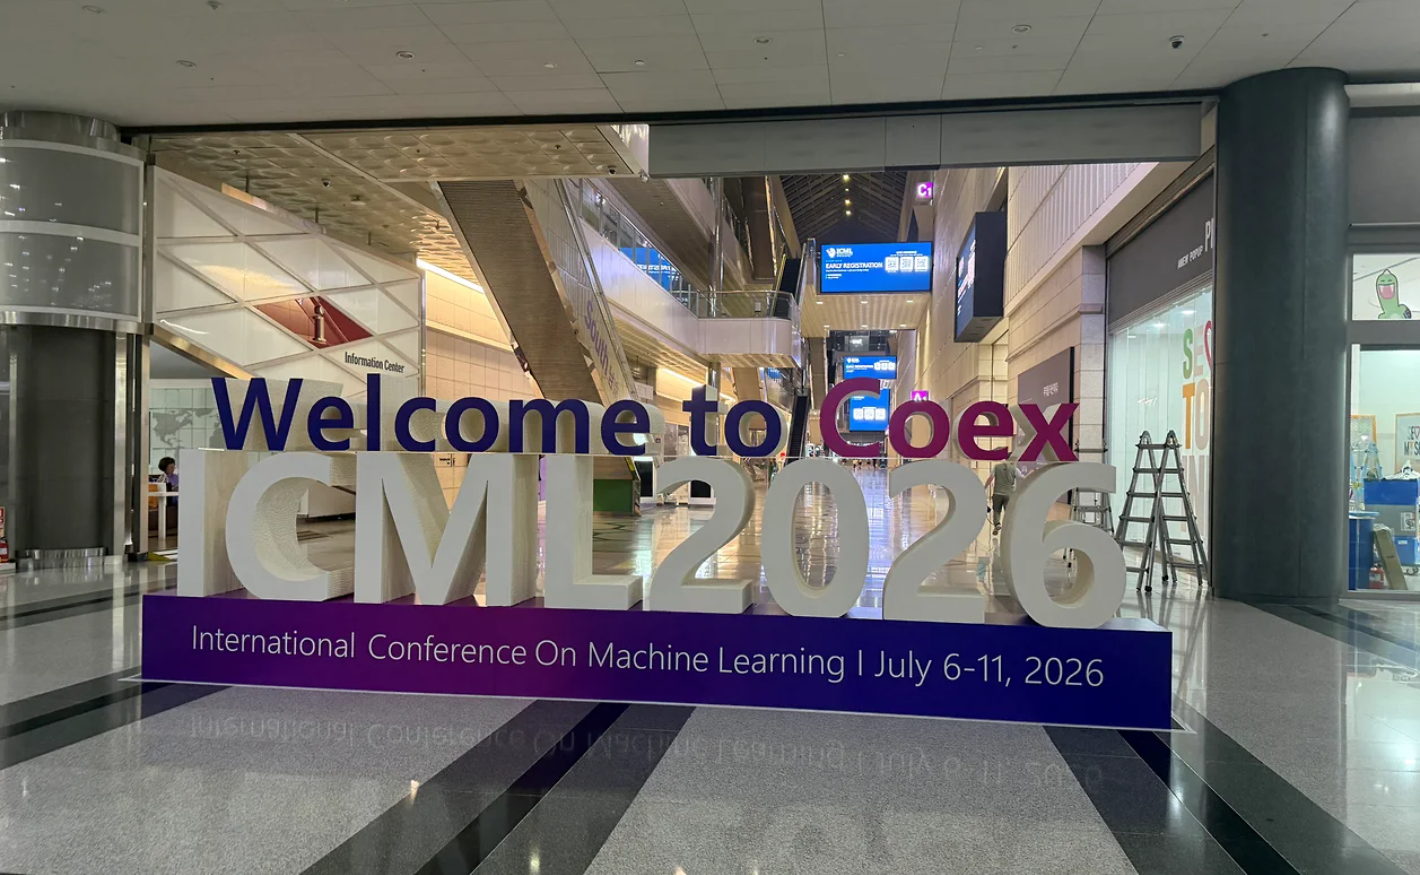
В Сеуле завершилась 43-я Международная конференция по машинному обучению (ICML) — одно из главных мировых событий в области искусственного интеллекта. В этом году организаторы получили 24 661 научную работу, приняли 6552 статьи, а на площадке COEX собралось более 22 тыс. участников. За неделю конференции прошло 168 устных докладов, почти 6 тыс. стендовых докладов, 44 тематических и четыре неформальные секции, а также десятки индустриальных выступлений.
По данным организаторов ICML 2026, количество участников, зарегистрированных на местах для участия в первой конференции, проходившей в Корее, составило 20 456 человек. Это крупнейшая конференция ICML, проводимая за последнее десятилетие, и это первый случай, когда были распроданы официальные билеты на конференцию ICML.
Главная ценность ICML — не в рекордных цифрах: представленные работы позволяют не только понять, что вызывает интерес у научного сообщества, но и какие идеи могут повлиять на продукты крупнейших зарубежных и российских технологических компаний. Среди участников и авторов в этом году были и исследователи из российских компаний, вузов и исследовательских центров: «Яндекса», Т-Банка, VK, «Сбера», AIRI, Сколтеха, НИУ ВШЭ и других.
В прошлые годы публичная дискуссия вокруг ИИ во многом была сосредоточена на масштабировании языковых моделей. На ICML 2026 стало заметно, что исследователи все чаще рассматривали не только модель, но и систему вокруг нее: инструменты, память, вычислительную инфраструктуру, стоимость и безопасность. Часть представленных идей со временем может повлиять и на продукты и сервисы, доступные пользователям.
При этом на ICML соседствовали как фундаментальные исследования, так и прикладные разработки. Как отмечает Алексей Ковалев, кандидат физико-математических наук, руководитель группы «Воплощенные агенты» лаборатории «Когнитивные системы ИИ» Института AIRI, современные крупные ML-конференции становятся все более универсальными: на одной площадке сегодня встречаются исследования практически по всем актуальным тематикам — от теоретических методов до робототехники и систем, способных взаимодействовать с физическим миром. «Одним из заметных трендов ICML 2026 стал рост интереса к робототехнике. Количество представленных по этому направлению работ увеличилось более чем в два раза по сравнению с предыдущим годом,— отмечает Алексей Ковалев.— Достаточно много работ было представлено по теме визуально-языковых моделей действий (VLA). Отдельно отмечу существенный рост общего числа представленных работ: по статистике организаторов, число заявок выросло примерно на 98%, то есть фактически в два раза по сравнению с предыдущим годом. Говоря о текущем фокусе научного сообщества, полагаю, что акцент на больших языковых моделях и агентах сохранится, при этом растет популярность моделей мира, и я уверен, что этот тренд продолжит развиваться, в том числе и в робототехнике».
От моделей — к системам
Главная мысль, которая прослеживалась практически во всех секциях конференции,— современный искусственный интеллект перестал быть исключительно вопросом архитектуры модели.
Все чаще исследователи изучают систему, внутри которой работает языковая модель: память, планирование, использование инструментов, маршрутизация запросов, безопасность, взаимодействие между несколькими агентами и распределение вычислительных ресурсов. Масштаб интереса хорошо иллюстрируют цифры самой конференции: термин agentic AI (автономные ИИ-агенты, способные самостоятельно действовать) встречался примерно в каждой четвертой заявке.
На конференции обсуждали, как хранить долговременную память агентов, как обучать их на собственном опыте, как восстанавливать порядок действий для параллельного выполнения задач и как эффективнее распределять запросы между GPU-кластерами. Это показывает, что производительность современного ИИ все чаще определяется не только качеством самой модели, но и инженерией системы вокруг нее.
Кроме того, отдельное внимание на конференции уделялось GUI-агентам: они способны выполнять действия через пользовательский интерфейс. Например, анализируют скриншоты или дерево доступности, нажимают элементы и заполняют формы. Исследователи обсуждают, что для таких систем оценки финального ответа недостаточно: необходимо проверять всю последовательность действий, устойчивость к ошибкам, безопасность и способность корректно завершать задачу.
Не меньше внимания уделялось тому, как оценивать работу таких систем. Для языковых моделей качество итогового ответа — лишь одна из характеристик для оценки. Также проверяются надежность, устойчивость, безопасность и предвзятость. При оценке агентов к ним добавляется анализ всей траектории действий, использования инструментов и восстановления после ошибок.
Экономика ИИ становится новой научной задачей
Еще одна тема, которая объединяла большое количество работ на ICML 2026,— эффективность современных моделей и стоимость их эксплуатации. Стоимость обучения и инференса, энергопотребление и память стали центральными ограничениями для исследований и промышленного внедрения ИИ. Поэтому все больше работ посвящено эффективности алгоритмов и систем.
Бывший исследователь Baidu и Google AI Джун Ван, комментируя актуальность работ на ICML 2026, отмечал, что эффективность перестает быть второстепенной инженерной задачей и становится одним из фундаментальных условий дальнейшего развития искусственного интеллекта. По его словам, индустрия уже обсуждает токенные бюджеты, стоимость инференса и возможность экономически эффективного масштабирования ИИ-продуктов. При этом системные исследования, которые ведут технологические команды вроде Google, Alibaba и «Яндекса», могут быть менее заметны, чем демонстрации новых моделей, но именно они определяют, какие ИИ-продукты смогут работать в глобальном масштабе.
Эта тенденция отражается в исследованиях, представленных на конференции. Google Research совместно с ISTA представили ECO — метод обучения квантованных LLM без хранения полной копии весов высокой точности. В протестированных конфигурациях он сокращал статическую память максимум на 25%. Университет MIT сформулировал теоретически, как мог бы работать алгоритм сэмплирования, у которого при достаточно точной оценке score число обращений к модели полилогарифмически зависит от требуемой математической точности, тогда как предыдущие гарантии давали полиномиальную зависимость.
Исследователи «Яндекса» представили Spotlight-работу «On Efficient Scaling of GNNs via IO-Aware Layers Implementations», в рамках которой были предложены GPU-ядра для распространенных слоев GNN, уменьшающие обмен с памятью и объем промежуточных данных. Эта работа показывает, что повышение эффективности ИИ-систем сегодня связано не только с созданием новых архитектур, но и с глубокой оптимизацией уже существующих методов обучения и вычислений.
«В этом году мы привезли на ICML сразу несколько исследований по разным направлениям — от масштабирования обучения больших языковых моделей и оптимизации графовых нейронных сетей до foundation-моделей для графов, поиска и табличного глубокого обучения,— комментирует Федор Великонивцев, старший исследователь Yandex Research.— В статье “On Efficient Scaling of GNNs via IO-Aware Layers Implementations”, которая родилась из проекта в ШАДе, мы разделили типовые слои GNN на три класса: свертки, простые агрегации-редукции и механизмы внимания. Для каждого нашли свое узкое место и оптимизировали его: для сверток использовали библиотеку NVIDIA cuSPARSE с дополнительными улучшениями; для агрегаций сбалансировали нагрузку между вершинами с разным числом соседей; для внимания адаптировали технику FlashAttention 2. В результате обработка ускорилась до 8,5 раза, а потребление памяти сократилось до 76 раз. По сути, мы переносим в графовые нейросети memory-efficient-подходы, которые уже стали стандартом в других областях машинного обучения».
Диффузия выходит за пределы генерации изображений
В массовом восприятии диффузионные модели долго ассоциировались прежде всего с генерацией изображений, хотя эксперименты с диффузией для дискретных данных и текста ведутся как минимум с 2021–2022 годов. На ICML 2026 стал прослеживаться тренд: следующей областью применения могут стать большие языковые модели.
Обе награды ICML 2026 в категории Outstanding Paper получили работы, связанные с диффузионными методами, одна из которых посвящена диффузионным языковым моделям.
В отличие от классических языковых моделей, которые генерируют текст последовательно — токен за токеном, диффузионные языковые модели итеративно могут уточнять несколько токенов на одном шаге, что потенциально позволяет получать конечный сгенерированный текст быстрее. Если этот подход подтвердит свою эффективность в промышленных системах, стоимость инференса может заметно снизиться.
Фундаментальные модели осваивают графовые данные
При этом развитие искусственного интеллекта идет не только по пути создания все более универсальных языковых моделей. Отдельное направление исследований связано со специализированными foundation-моделями, которые работают с другими типами данных — например, графами, изображениями, молекулами или временными рядами.
Одним из примеров такого направления стала работа исследователей «Яндекса» в области графового машинного обучения. Статья «GraphPFN: A Prior-Data Fitted Graph Foundation Model» получила награду Best Paper Award на ICML-воркшопе по графовым foundation-моделям.
Авторы предложили модель, предварительно обученную на миллионах специально сгенерированных синтетических графов. После такого обучения GraphPFN способна решать задачи на реальных данных как в режиме in-context learning, так и после дополнительного дообучения. По результатам экспериментов модель показала лучшие результаты среди протестированных авторами подходов на широком наборе реальных графовых датасетов.
«Мы представили графовую foundation model, развивающую подход Prior-Data Fitted Networks (PFN). Она предобучается на миллионах специально сгенерированных синтетических графов, а затем может эффективно решать задачи на реальных данных как в режиме in-context learning, так и после дообучения. На широком наборе реальных графовых датасетов GraphPFN обходит все остальные протестированные модели»,— комментируют в Yandex Research.
Итоги
ICML 2026 показала, что фокус исследований в области искусственного интеллекта постепенно смещается от разработки отдельных моделей к созданию комплексных ИИ-систем. В центре внимания оказались не только новые архитектуры, но и вопросы эффективности, безопасности, автономной работы и интеграции моделей в реальные продукты.
Еще больше новостей |  |